

introduction
前几天看某pdf学习注意力机制,看到介绍pointer-network(指针网络)的内容,觉得很有意思,故顺手把原论文拿来研究一番,竟然大有功夫。(论文地址见附录)
这个指针网络是传统seq2seq模型的一个延伸:原来的seq2seq模型分为encoder和decoder,encoder是一个RNN,对输入序列进行编码;decoder也是一个RNN,对encoder的隐藏层进行解码,解码若干次,把输出序列作为最终输出。
之后出现了一个经典改进,decoder每次解码后再加上一个注意力层(attention),将注意力层输出作为decoder下一次的输入。注意力层的作用在于让decoder下次解码聚焦于之前seq的某段信息,从而在同等维数的情况下得到更精准的输出。
论文中的注意力层内部如下:({e}为encoder输出,{d}为decoder第i次解码的隐藏层)
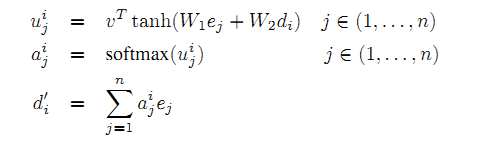
但是论文作者说:为什么不直接通过注意力层得到概率呢?
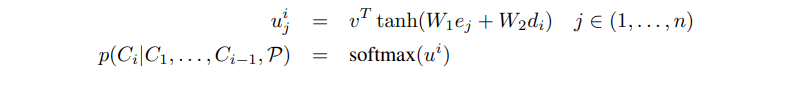
这样做的一个重要的好处在于输出概率的长度依赖于输入长度而非网络自身规定好的配置,而且更加直观了:聚焦概率最高的东西是谁就输出谁。
因此,ptr-net很适合解决输入序列{b},输出序列一个下标组{b_c1,b_c2,...,b_cn}的问题。
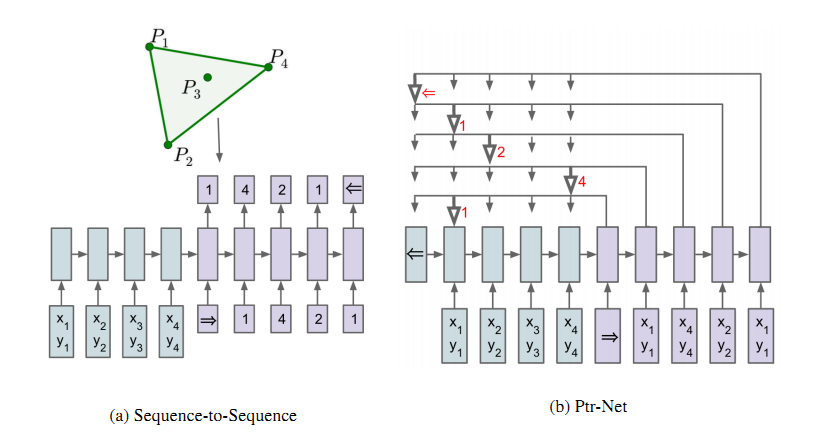
然后论文用这个net分别解决找凸包、找三角剖分、TSP问题,取得了不错的成果,虽然与一些近似算法比没有什么优势(要长时间训练,且n变大效果滑坡明显),但一个神经网络能够解决算法领域的问题还是给了我不小的震撼,特别TSP还是NPC问题,它是如何学习到近似算法的呢?
work
为了在自己电脑上实现这种震撼(顺便学习attention),我主要参考了github上某位大神的代码(地址见附录),再结合论文的公式,最后捣鼓出了一个能跑的net.
由于我参考的代码只写了TSP的部分,所以我也只用TSP进行测试,而且TSP的一个关键好处在于输入长度固定时输出长度是定长的(所有点都走一遍),因此也不用考虑不定长怎么求损失的问题。
怎么定义损失函数呢?一般想法可能就直接依据net的输出计算TSP的长度,再求均方差——行不通,因为如果net输出是确定值(max),那么TSP长度也由确定值计算,但max没法求梯度,那么神经网络就没法训练了。
所以net本身是没法求TSP长度的,只能输出softmax(概率向量),和标准答案通过交叉熵计算损失,这时就能计算梯度进行训练了。
由于答案是一个环,可以有2n种最优解,故人为规定第一个元素为1,然后每次求损失时将原序列与倒转后的序列与net输出进行比对,选择损失较小的那个。
虽然交叉熵不能完全反映net输出与最终答案的距离,但用来学个大致的模样还是可行的。训练时最有趣的地方在于:你的训练样本可以是无穷大的!随便生成一组[0,1]x[0,1]的随机数据,丢给一个算法跑出最优解就可以了。
唯一的问题在于O(2^n*n^2)的暴力实在太慢了...于是最开始只用n=10样本进行训练。(之后n更大时用近似算法训练)
无穷大的样本导致训练集和测试集其实没啥区别:都是随机生成一组数据,因此在某种意义上避免了过拟合问题,新的问题取而代之:损失值的方差很高,经常颠簸许多次后才会慢慢下降(甚至不下降)。
优化来优化去发现每当损失值下不去时,把batch_size提高一段就行了= =...
result
使用n=10~20的数据多次训练;测试时直接计算TSP长度进行比较。
令人惊讶的是net的近似解与最优解比相当准了。
n=10,取测试集大小=1024,std平均TSP长度=2.87,近似平均TSP长度=3.06,net平均TSP长度=2.97,net和std平均相对误差为0.037;
n=20,取测试集大小=1024,近似TSP=4.23,netTSP=4.13,比近似算法好了不少;
n=30,测试集大小=1024,近似TSP=5.12,netTSP=5.14;
n=50,测试集大小=1024,近似TSP=6.45,netTSP=6.87,和近似算法有一定差距,但若用n更大的数据训练应当能降低TSP长度。
这里相对误差(a,b)=max(a-b,0)/b,a为net解,b为最优解/算法近似解
太震撼了!它是怎么做到的??
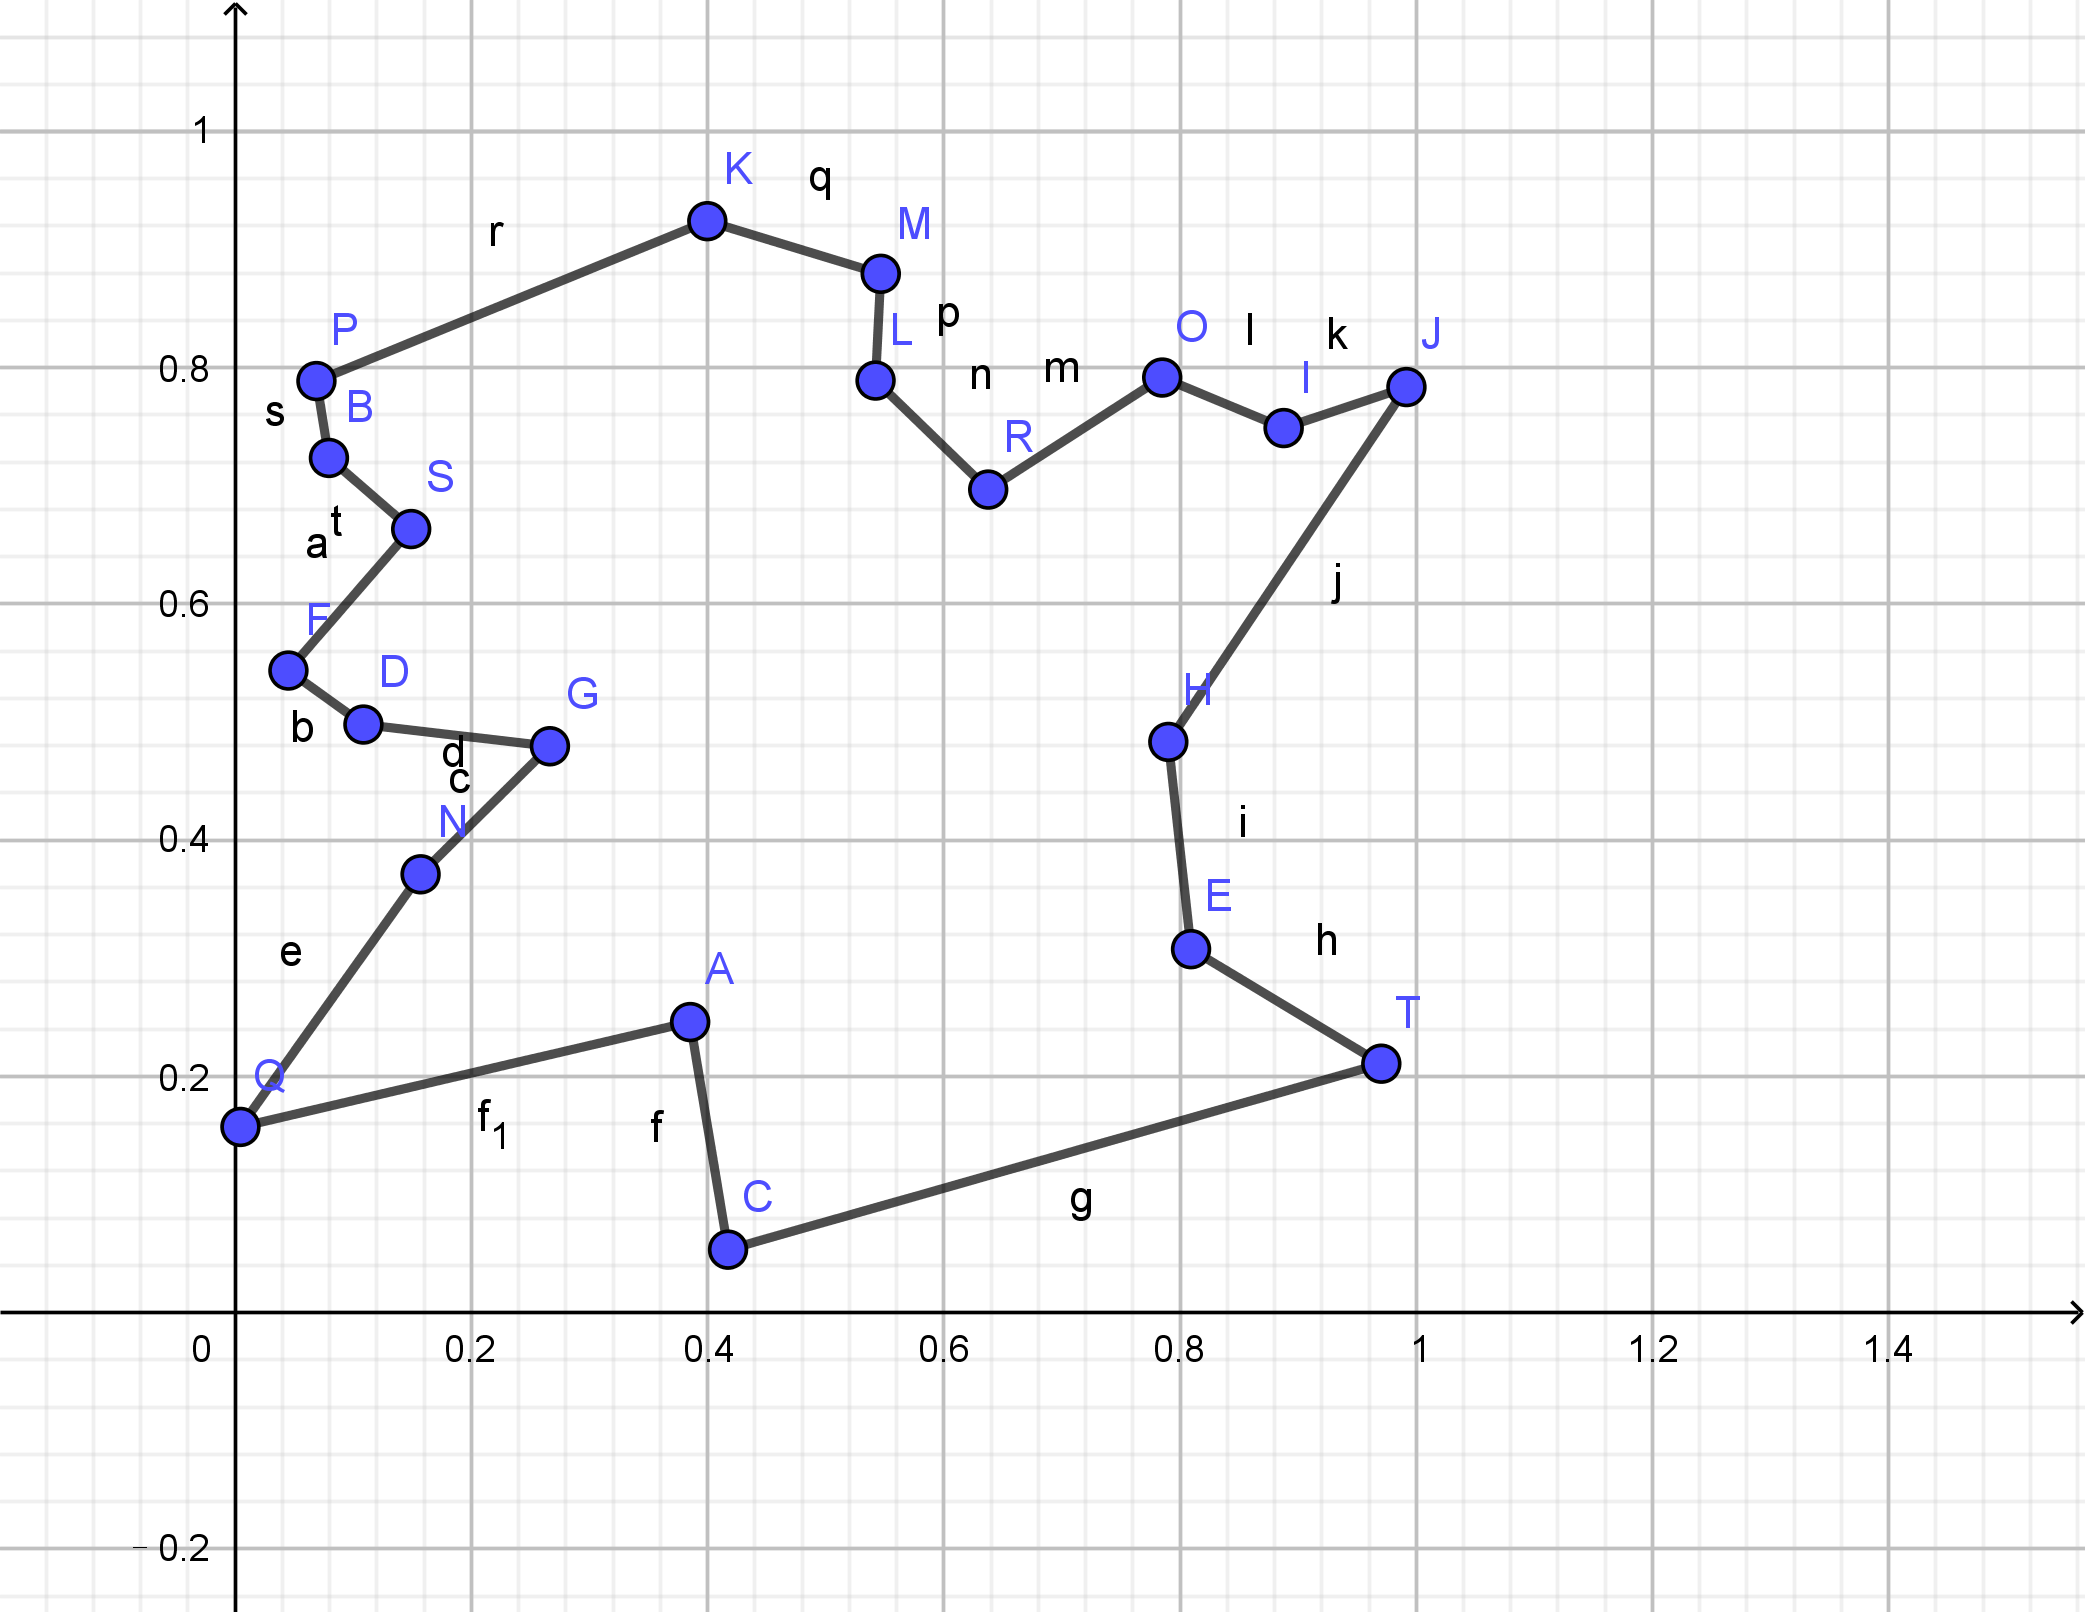
贴一张n=20时较好的近似解:
 |
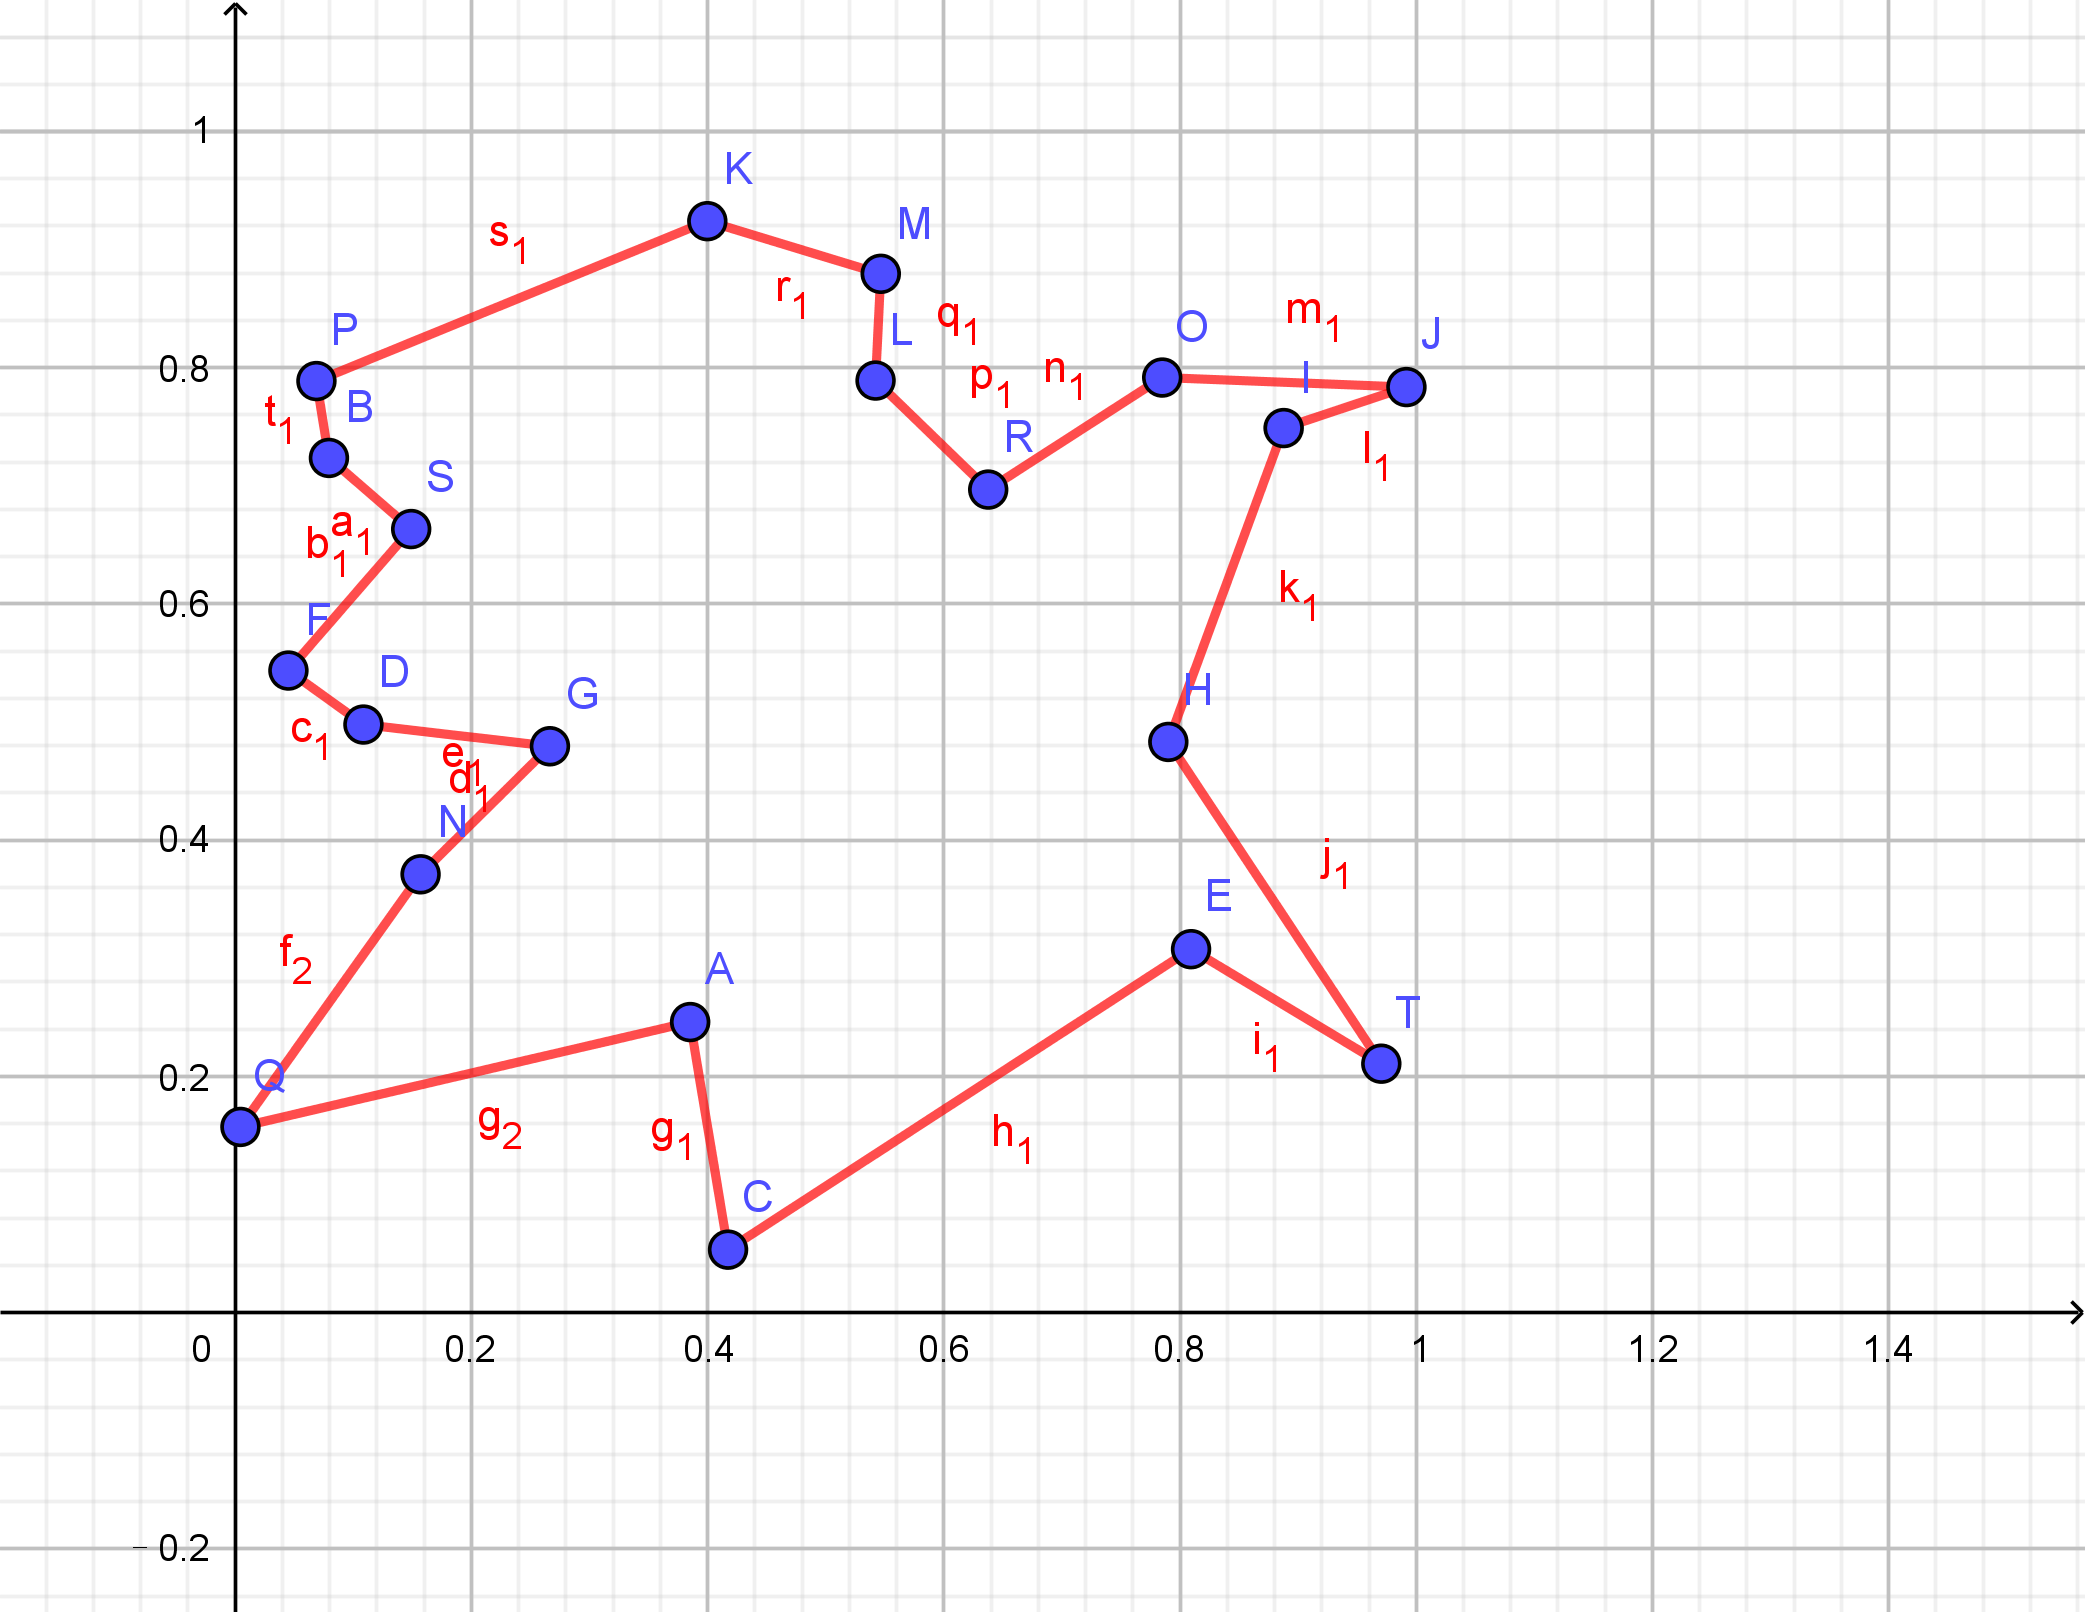 |
stdTSP = 3.989 netTSP = 4.048
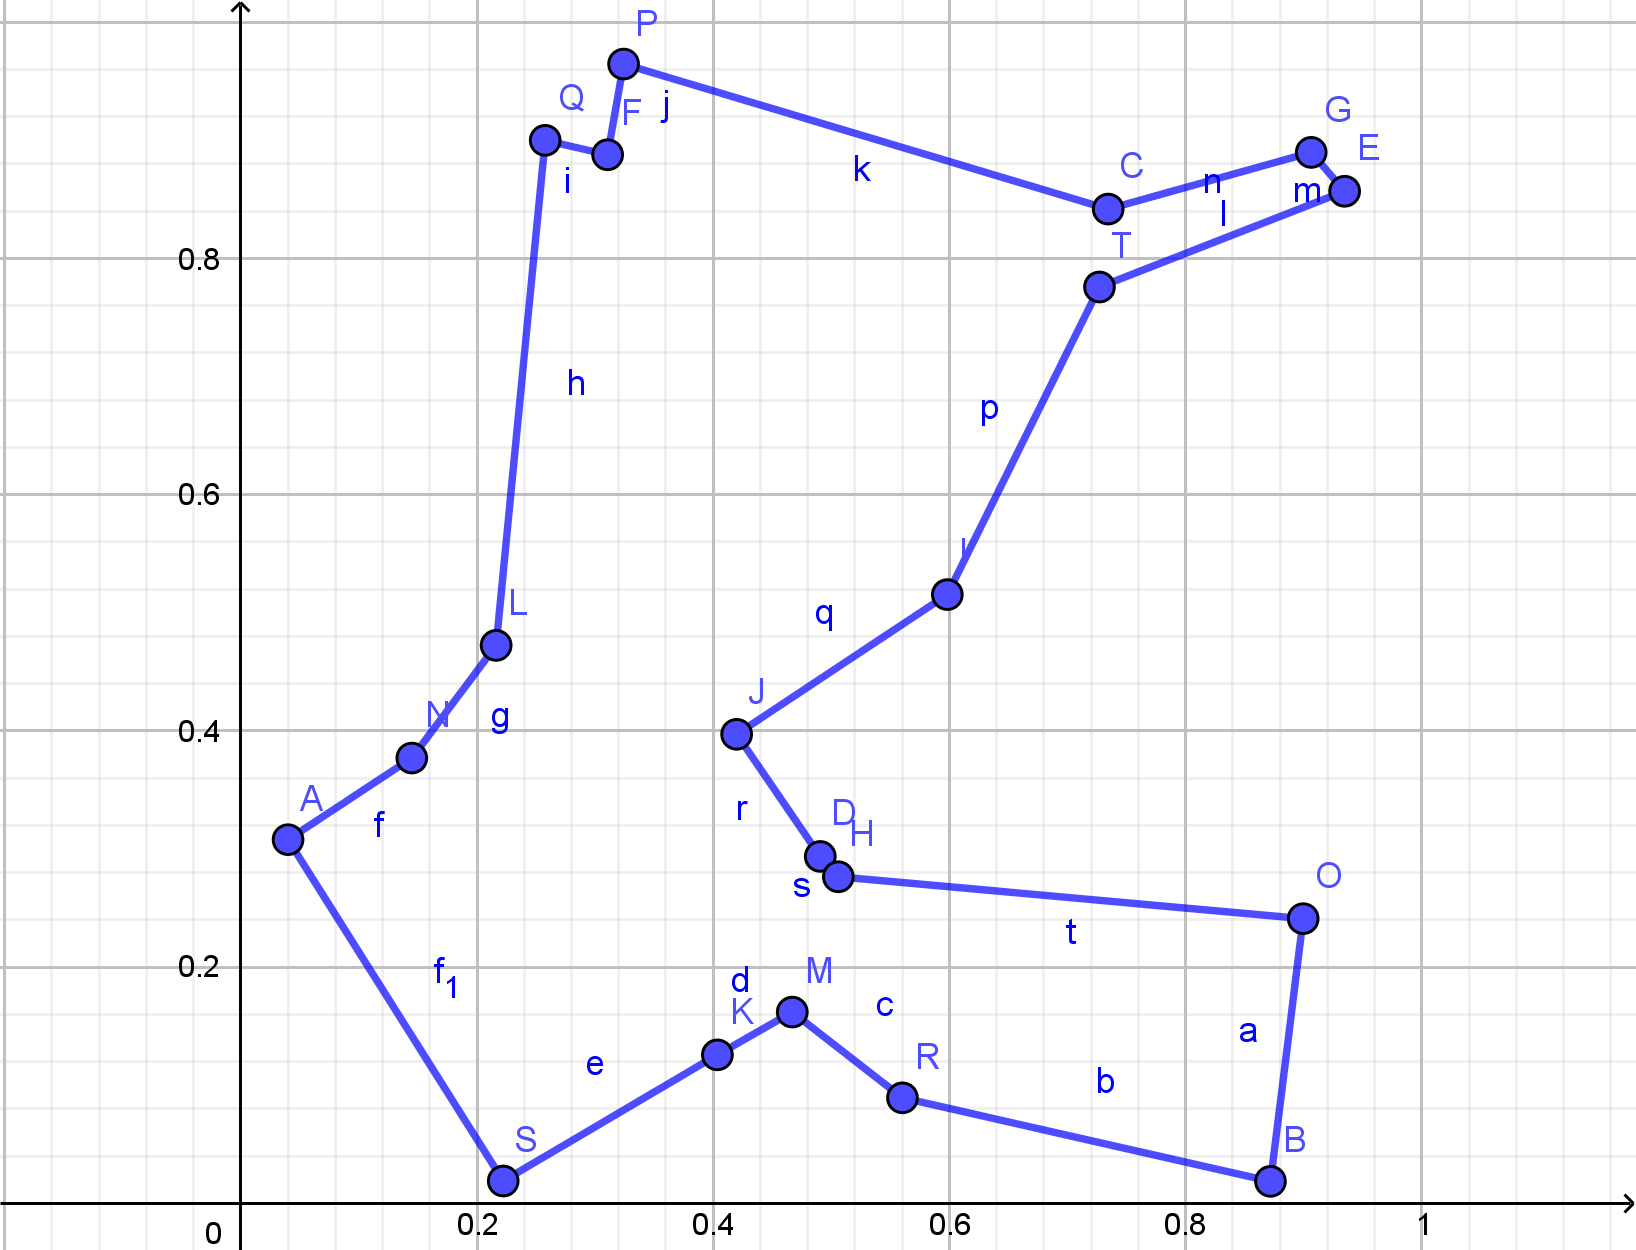
另一张n=20时不那么好的近似解:
 |
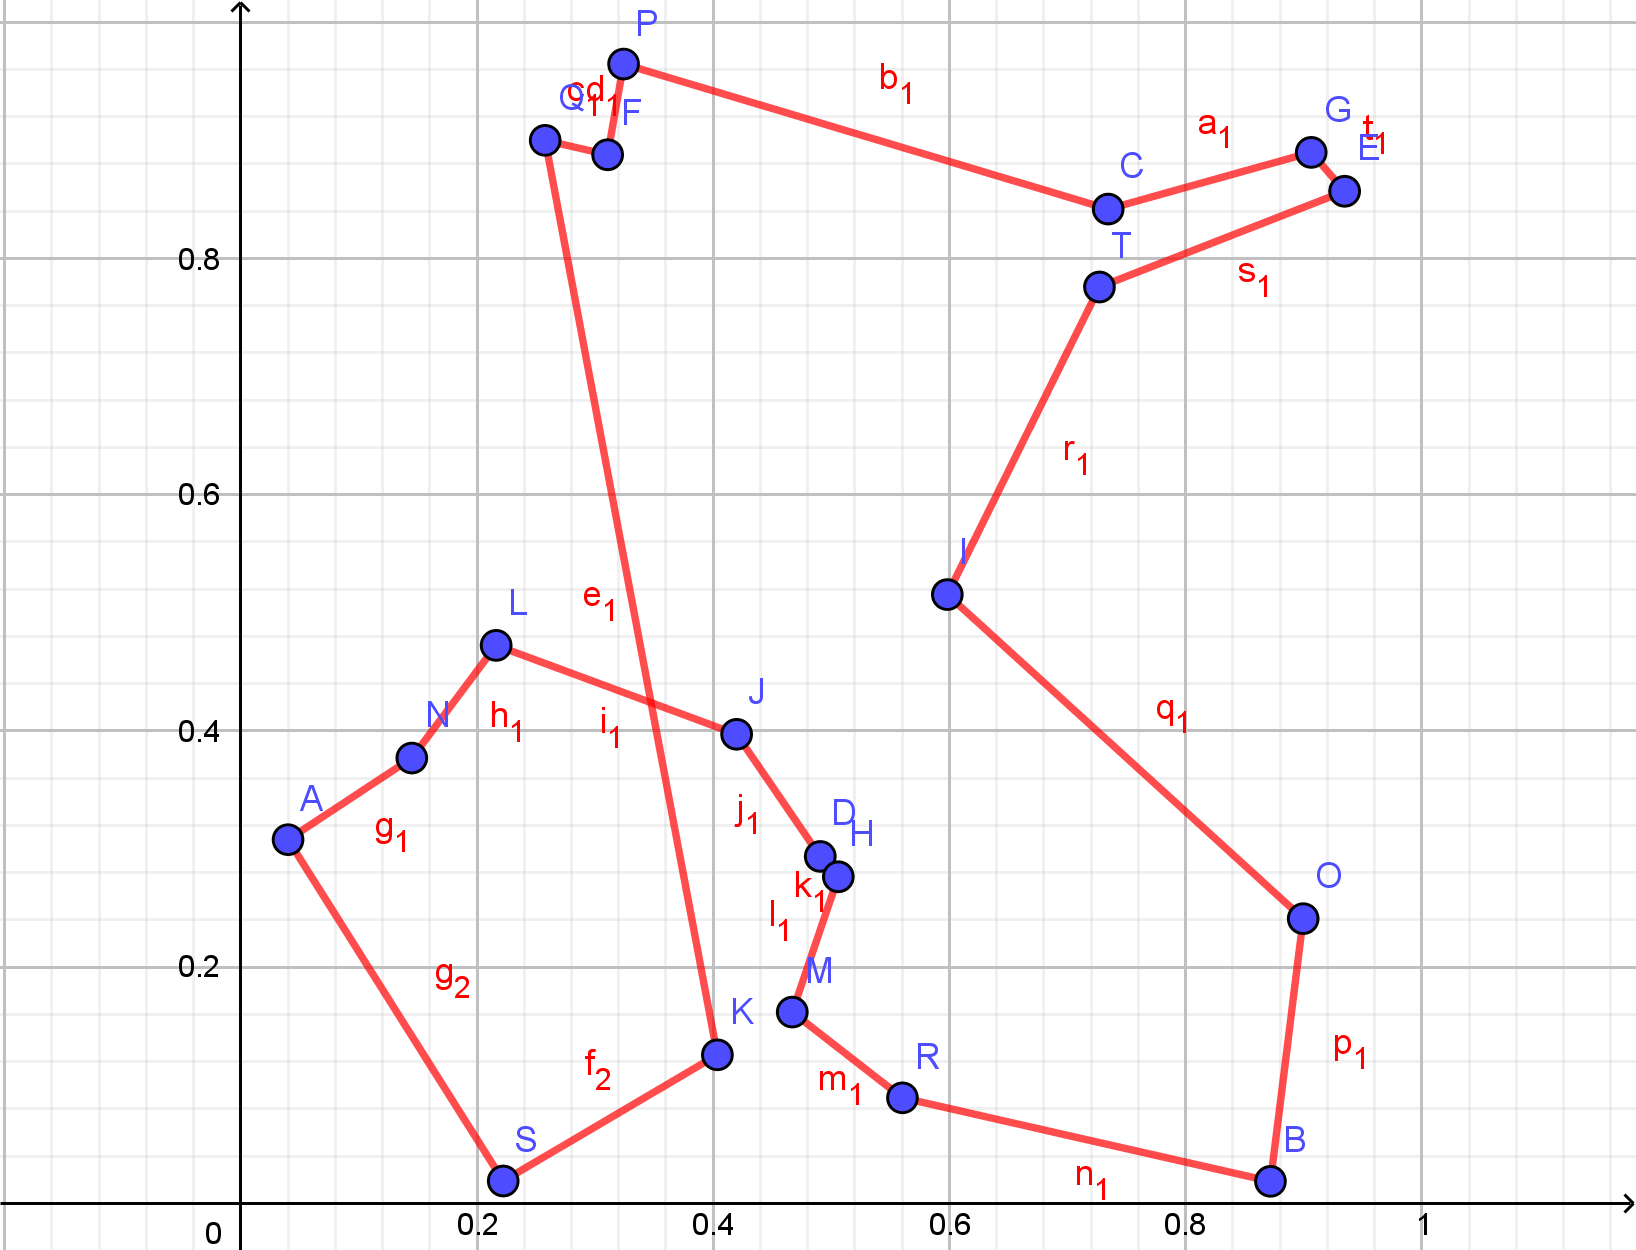 |
stdTSP = 4.015 netTSP = 4.436
虽然ptr-net能够学得有模有样令人惊奇,但其与一些近似算法仍然有一定的差距。更重要的是:我们仅仅将输入和输出丢了进去,其他什么都没做;但TSP问题显然是有其内在规律的,我们应当通过其他图论、计算几何等知识去真正地“解决”,而非将输入和输出丢给机器让机器去“模仿”,因为“模仿”一定永远没法得到比“模仿者”更好的结果。
(在github里搜索TSP,top1为使用Self-Organizing Maps(一种神经网络聚类算法)解决TSP问题的代码,这应该是针对性较强,效果较好的方法了,具体也没研究)
appendix
1.ptr-net论文(NIPS15)
2.github ptr-net pytorch
3.github TSP近似算法
Comments | 2 条评论
博主你好!
Pointer networks论文中指出它是一个数据驱动的模型,我理解为它可以解决很多类似类似的组合优化问题,只要喂数据训练就可以了。那么如果是0/1背包问题的话,是不是直接喂数据训练就可以了,或者应该修改模型进行训练呢?
@1004026475 我的理解,01背包应该算做一个打标签的分类问题(0选择物品1不选择物品),和TSP的排序问题有一点差别,如果用生成式的方法来做的话,一个n物品,最优解选了m物品的正例相当于有2^m种生成的形式,这可能不利于模型学习正例的真正含义(推测)。